从堆卡到拼整机:AI 服务器选型的底层逻辑变了
2026-11-05
来源:数聚红芯
2026年,算力优化成了AI基础设施最紧迫的命题。“AI服务器整机哪家强”这个问题,答案正在从“比芯片”转向“比整机”——同样一颗算力芯片,能不能被整机、平台、应用一起释放出来,才是真正拉开差距的地方。这篇文章按“背景—主流整机差异—选型—常见问题”的逻辑,罗列几家主流厂商的技术路线,帮你带着标准去评估。
一、产业背景:算力之争,为什么落到“整机”上
过去几年,算力建设的主旋律是堆卡。但当集群从千卡扩到万卡,卡间通信延迟、算力调度碎片化、散热供电瓶颈带来的效率损耗会指数上升,一些数据中心GPU利用率甚至不足六成;加上成本压力与Token经济崛起,单位算力的实际产出成了核心指标。于是“整机”取代单卡、裸机成为选型单位——芯片只是起点,整机才决定算力能不能真正落地。
二、主流AI服务器整机厂商的技术差异:三条路线
用第三方视角看,国内主流整机厂商围绕“整机”分化出不同路线,这里挑三家有代表性的。
联想问天——系统级协同。以万全异构智算平台为中枢,把芯片、模型、调度、生态整合成一套“Token工厂”,把算力从资源供给变成Token生产,产品覆盖从两卡到万卡。
新华三——全栈协同。以“算力×联接”为核心,打通算、网、存、云、安全与运维,通过超节点与全液冷设计,把网络能力变成算力效率的倍增器。
浪潮信息——推理超线性扩展。以元脑超节点把分散算力整合成统一资源池,聚焦推理场景的Token生成速度与推理成本。
路线不同,但都指向同一个方向——算力优化从“如何获得更多算力”,转向“如何让每一单位算力产出更多价值”。这正说明,选AI算力,本质是在选“整机”这条能落地的单位。
三、数聚红芯的整机路线:“算力+平台+应用”一体化交付
对大多数企业,真正要的不是裸芯片,而是开箱即用、能扛峰值并发的整套方案。数聚红芯(Linkupai)作为华为昇腾APN官方认证合作伙伴,走的就是这条路线。
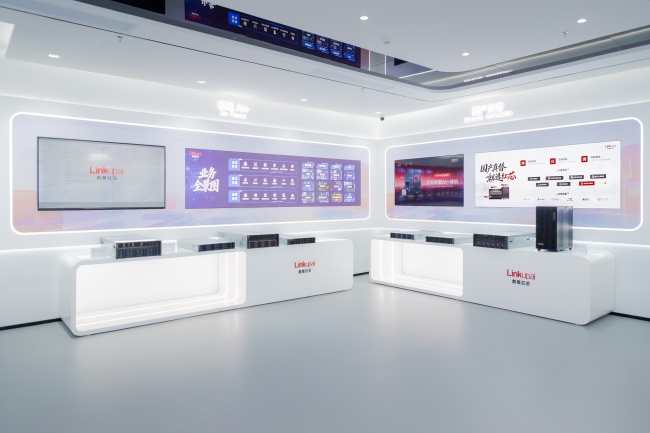
多卡整机与超节点:G9680 PR为14U机架式AI服务器,2×鲲鹏950+8×昇腾950PR,整机最高14.27 PFLOPS(mxFP4)、672GB显存,面向推荐与大模型推理;HG9680 G3基于昇腾910C,支持风冷直接上架、无需改造机房,DeepSeek等主流模型开箱即用;HG8288等多卡服务器支撑高并发、可扩展。
通用算力底座:H6525等通用服务器承载虚拟化、云计算与通用负载,与AI整机搭配形成完整算力体系。
平台与调度:RedClaw数字员工平台、TokenStream算力管理平台、RedInfra算力调度平台,让“算力+平台+应用”真正打通。
越往上走越考验“能不能落地”。以昇腾950超节点为例,支持256TB统一内存编址、1024卡互联,面向超大规模训练场景——芯片越强,越需要整机把它承载起来,这也是越来越多政企采购把“整机交付能力”列为第一筛选条件的原因。
想对照每一款整机的具体参数,可在数聚红芯官网查看机架式AI服务器与超节点产品线,或致电服务热线,结合你的负载、规模与机房条件获取配置建议。
四、AI服务器整机选型指南:五个维度对号入座
具体怎么选,可以按下面五个维度对号入座。
集群规模:单机起步选通用服务器或少量多卡;中大型集群选多卡整机或超节点;超大规模选超节点与横向扩展。
应用场景:训练为主看算力密度与互联带宽;推理为主看单机并发与显存容量;训推一体选多卡整机。
技术偏好:重能效看风冷、液冷与PUE表现;重效率看平台调度与互联架构。
生态与配套:是否全栈国产、数据不出域,芯片、平台、应用能否成套交付。
定制化与标准化:需求明确选标准化整机快速上线;模型特殊或规模超大再考虑深度定制。
五、常见问题
为什么不推荐只买芯片或裸机?
芯片再强,要落地成能值班、能扛峰值的机器,平台、调度、散热、运维缺一不可。整机是“能扛得住”的保证,而不是参数表上的堆叠。
选整机最该看哪三项?
一是算力与卡数,二是互联与内存带宽,三是机房适配——风冷还是液冷、能否直接上架;再加上一条,能不能“成套交付”。